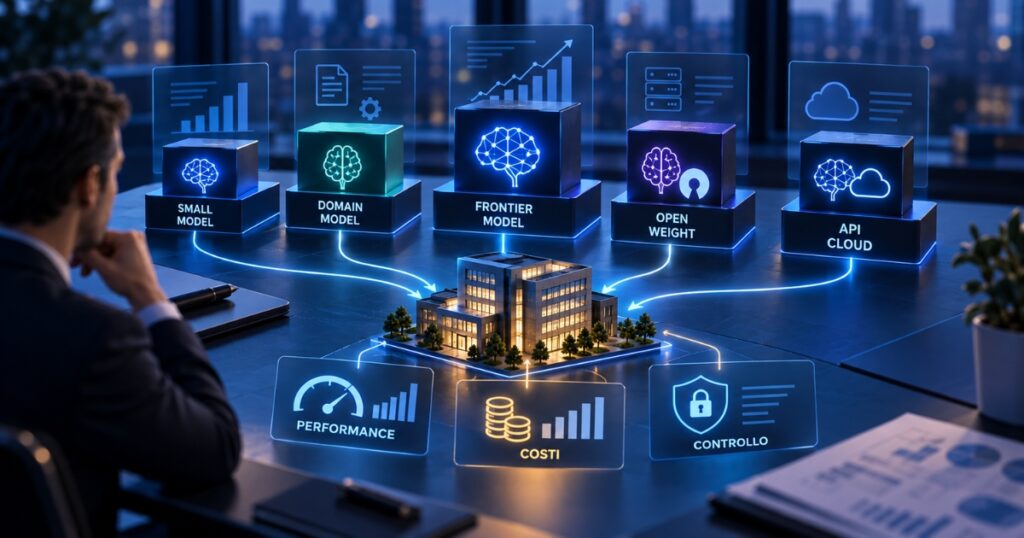
Decidere quale modello AI scegliere non è più una questione tecnica isolata, ma una scelta che intreccia budget, governance dei dati e strategia di fornitura. Le aziende confrontano oggi modelli di frontiera e modelli più piccoli, API cloud e installazioni in proprio, un solo fornitore o un portafoglio di più laboratori. Capire dove serve davvero il modello più potente, e dove invece un modello più piccolo basta e costa meno, è il primo passo per non sprecare budget o esporsi a rischi inutili.
Quale modello AI scegliere: quando serve la frontiera e quando basta un modello piccolo
La distinzione più utile non è tra “modello buono” e “modello scarso”, ma tra compiti generici e compiti specifici di dominio. Gartner ha inserito i modelli linguistici specifici per dominio (DSLM) tra i trend tecnologici strategici per il 2026, prevedendo che entro il 2028 oltre la metà dei modelli generativi utilizzati dalle aziende sarà specifica per dominio anziché general-purpose, per rispondere con maggiore accuratezza, affidabilità e aderenza alle esigenze di business [1]. Secondo un successivo approfondimento di Gartner, i DSLM possono offrire costi di sviluppo fino al 50% inferiori rispetto ai modelli linguistici generali, pur richiedendo una valutazione delle prestazioni caso per caso [1].
Anche il calcolo economico va fatto sul compito e non sul listino: conta quanto costa una risposta corretta, non quanto costa un singolo token. Secondo un’analisi pubblicata da Agenda Digitale, il modello più potente può essere la scelta sbagliata: una valutazione utile per le imprese deve misurare le prestazioni nei compiti reali, i costi, la sicurezza e la possibilità di installazione interna [2]. Quali voci compongono il costo di un sistema, oltre al prezzo per token, è il tema dell’articolo sul costo dell’AI agentica.
Secondo una stima di Mordor Intelligence, i modelli con meno di 100 miliardi di parametri avrebbero rappresentato il 69,20% dei ricavi del mercato LLM nel 2025 [3]. Il dato proviene da un modello di stima proprietario della società di ricerca, non da una rilevazione pubblica indipendente: non dimostra, da solo, che una determinata architettura hardware o taglia di modello sia economicamente adatta a ogni azienda.
Benchmark pubblici: cosa misurano davvero e dove si fermano
I benchmark restano il punto di partenza per confrontare i modelli, ma hanno limiti strutturali. Secondo IBM, pur essendo indicatori solidi delle prestazioni, i benchmark non possono prevedere come un modello si comporterà nel mondo reale, e quando un modello raggiunge il punteggio massimo su un test, quel test va aggiornato con compiti più difficili per restare utile [4]. Le metriche più comuni includono accuratezza, precisione, richiamo, F1 score, latenza, throughput, uso della memoria, efficienza computazionale, consumo energetico e tasso di errore, distribuite su categorie di benchmark specifiche per compito, comprensive di prestazione e di equità [5].
Per valutare la convenienza di un modello occorre quindi considerare metriche misurate su attività rappresentative dei casi d’uso aziendali [4] [5]:
- accuratezza, precisione, richiamo e F1 score per i compiti di classificazione ed estrazione delle informazioni;
- latenza e throughput per velocità di risposta e capacità di elaborazione;
- consumo energetico ed efficienza computazionale per valutare l’utilizzo delle risorse [5].
OpenAI stessa presenta la scelta come un compromesso. La sua guida alla scelta del modello mette agli estremi della propria gamma un modello più economico ed efficiente e uno più potente: se costi e latenza non sono un vincolo, suggerisce il secondo; per ridurli, indica di scegliere il modello e il livello di ragionamento adatti al compito [6]. La stessa guida tratta le proprie indicazioni come un punto di partenza: il modo migliore per trovare il modello giusto è sperimentare sul proprio flusso di lavoro, confrontando i risultati sugli stessi input e tenendo l’impostazione più leggera che raggiunge il livello di qualità richiesto. Prima di farlo, suggerisce di chiedersi quanto spesso gira il processo, quanto in fretta serve il risultato, come verrà usato e quanto conta la qualità [6].
Protezione dati, conformità e licenze: API, self-hosting e modelli open-weight
Chi usa un modello via API deve verificare cosa succede ai propri dati. OpenAI dichiara di non addestrare i propri modelli sui dati aziendali dei clienti per impostazione predefinita su ChatGPT Enterprise, Business, Edu e API, e descrive pratiche conformi a GDPR, CCPA, standard CSA STAR, SOC 2 Tipo 2 e certificazioni ISO/IEC 27001, 27017, 27018, 27701, oltre a un Business Associate Agreement per i clienti sanitari [7]. Anche Anthropic dichiara che gli input e gli output dei prodotti commerciali, come Claude for Work e le API, non vengono utilizzati per addestrare i modelli per impostazione predefinita, salvo consenso esplicito o invio volontario di feedback. Per le API Anthropic, l’eliminazione standard degli input e degli output dai sistemi di backend avviene entro 30 giorni, con eccezioni documentate; nei prodotti commerciali che consentono di conservare conversazioni e sessioni, valgono regole specifiche. I piani personali Free, Pro e Max seguono condizioni diverse, da verificare prima di trattare dati aziendali [8].
Per chi vuole tenere i dati dentro il proprio perimetro, i modelli open-weight offrono un’alternativa concreta. Secondo un approfondimento di ZeroUno che riprende l’analisi Gartner, l’esecuzione on-premise, in cloud privato o in edge può aiutare a mantenere dati sensibili entro l’infrastruttura controllata dall’organizzazione; tuttavia il solo rilascio dei pesi non equivale a trasparenza totale, perché informazioni su dati di addestramento, filtraggio e sicurezza possono restare riservate [9]. Che cosa impone il quadro normativo a chi sposta dati sensibili nel cloud è il tema dell’articolo sulla sovranità dei dati nel cloud europeo. Sul fronte delle licenze, non tutti i modelli della stessa famiglia seguono necessariamente gli stessi termini: Mistral AI specifica che la maggior parte dei propri modelli aperti usa la licenza Apache 2.0, mentre alcuni sono regolati da una licenza MIT modificata, che chiede alle aziende con un fatturato mensile superiore a 20 milioni di dollari di ottenere una licenza commerciale o di usare i modelli tramite la piattaforma Mistral Studio; Llama 4 di Meta utilizza una licenza comunitaria proprietaria che comprende vincoli e condizioni commerciali, tra cui una soglia di utenti mensili [10].
Più modelli, instradamento delle richieste e dipendenza da un solo fornitore
Tra i fornitori, Snowflake, che vende una piattaforma per dati e AI, sostiene che vincolare ogni caso d’uso a un unico modello possa limitare prestazioni, controllo dei costi e adattabilità, perché un altro fornitore può emergere all’improvviso con un’innovazione che chi è vincolato rischia di perdere [11].
I dati sull’adozione vanno nella stessa direzione. Un sondaggio su 100 CIO enterprise condotto da Andreessen Horowitz nel 2025 rileva che il 37% degli intervistati utilizza cinque o più modelli, contro il 29% dell’indagine precedente, e indica nella differenziazione dei modelli per caso d’uso la ragione principale per cui le aziende acquistano da più fornitori [12]. Un sondaggio separato di Dataiku, condotto con Harris Poll su 600 CIO enterprise nel mondo, trova che l’81% prevede di affidarsi a due o più fornitori di LLM nel 2026 per restare competitivo, e il 93% ritiene che LLM diversi offrano prestazioni migliori per casi d’uso diversi [13].
Questo non significa, però, che le aziende sostituiscano continuamente i propri fornitori. Un’analisi pubblicata su arXiv come preprint, non ancora sottoposta a peer review, sintetizza dati tratti da precedenti ricerche secondo cui solo l’11% dei team enterprise ha cambiato fornitore di modelli nell’ultimo anno, mentre il 66% ha aggiornato a un modello più recente dello stesso fornitore già in uso. Questi risultati suggeriscono che le aziende tendano ad ampliare il proprio portafoglio di modelli anziché sostituire sistematicamente i fornitori esistenti, ma richiedono cautela perché provengono da indagini differenti [14]. Un report Menlo Ventures del 2025 citato da Orion Innovation mostra quanto rapidamente possano comunque spostarsi le quote di spesa tra fornitori esistenti: la quota di Anthropic sulla spesa enterprise in API LLM è passata dal 12% nel 2023 al 24% nel 2024 al 40% nel 2025, mentre quella di OpenAI è scesa da circa il 50% al 27% nello stesso periodo [15].
Il costo di un cambio di modello non pianificato può essere significativo. Secondo un’analisi di Orion Innovation, che attribuisce la stima a Gartner, il costo aggiuntivo di cambi di modello forzati e non pianificati è compreso tra il 15% e il 25% del costo totale di implementazione AI su tre anni, pari a circa 300.000-500.000 dollari di rilavorazione su un’implementazione da 2 milioni di dollari [15]. Si tratta di una stima riportata da una fonte secondaria, non necessariamente applicabile a ogni progetto. Sul fronte della governance pubblica, una relazione della Commissione CIAAR dedicata all’applicazione dell’intelligenza artificiale alle funzioni del Ministro per gli Affari Regionali e le Autonomie segnala che l’adozione di un sistema AI può generare dipendenza strutturale dal fornitore, con costi di cambiamento, perdita di competenze interne e vulnerabilità a modifiche contrattuali unilaterali. La relazione raccomanda architetture interoperabili su standard aperti, clausole contrattuali sulla reversibilità e continuità del servizio e diversificazione dei fornitori. Queste indicazioni, nate per uno specifico contesto della Pubblica Amministrazione, possono offrire criteri di valutazione anche alle imprese private, senza presumere che rischi e impatti economici siano identici nei due ambiti [16].
Perché conta per chi decide
Capire quale modello AI scegliere significa valutare le esigenze di ogni caso d’uso, bilanciando qualità delle risposte, costi operativi, protezione dei dati e flessibilità tecnologica. I modelli di frontiera possono essere riservati alle attività che ne giustificano il costo, mentre modelli più piccoli o specializzati possono rappresentare alternative per compiti circoscritti.
Le analisi sui costi dei cambi di modello non pianificati e i dati sull’adozione di più fornitori evidenziano l’importanza di considerare anche la reversibilità delle scelte tecnologiche [12] [13] [15]. La selezione di un modello AI dovrebbe quindi essere trattata come una decisione architetturale da riesaminare nel tempo, non come un acquisto definitivo.
Fonti
- Gartner Identifies the Top Strategic Technology Trends for 2026 — Gartner, 20/10/2025; approfondimento Domain-Specific Language Models: GenAI as a Precision Tool, 02/03/2026.
- AI in azienda, perché il modello più potente può essere la scelta sbagliata — Agenda Digitale, Paolino Madotto | 16/09/2026.
- Large Language Model Market Size, Growth & Outlook | Industry Report 2031 — Mordor Intelligence | stime proprietarie aggiornate al 2026, non verificate indipendentemente.
- Cosa sono i benchmark LLM? — IBM, Rina Diane Caballar e Cole Stryker | 29/01/2024.
- Benchmarking — FlowHunt.
- Model selection — OpenAI, documentazione API.
- Privacy, sicurezza e conformità dei dati aziendali — OpenAI.
- Per quanto tempo conservi i dati della mia organizzazione? e I miei dati vengono utilizzati per l’addestramento del modello? — Anthropic Privacy Center, documentazione commerciale 2026.
- Open Source AI: la sfida europea tra sovranità digitale e vantaggio competitivo — ZeroUno, Mattia Lanzarone | 11/08/2026.
- Con quale licenza sono disponibili i modelli open di Mistral? — Mistral AI, 12/08/2026; Llama 4 Community License — Meta.
- Agenti AI: architettura e governance — Snowflake.
- How 100 Enterprise CIOs Are Building and Buying Gen AI in 2025 — Andreessen Horowitz | 10/06/2025.
- Decision 5 of 7: When AI Model Choices Become a Switching Problem — Dataiku, Julia Berman | 16/04/2026.
- The Multi-Lab Enterprise: Governance, FinOps, and Telemetry Challenges of Multi-Model AI Adoption — Fabricio F. Costa, arXiv | preprint, non peer-reviewed.
- Model-Agnostic AI Architecture for Enterprises — Orion Innovation; contiene stime attribuite a Gartner e dati ripresi da Menlo Ventures.
- Relazione finale della Commissione di studio sull’applicazione dell’intelligenza artificiale alle funzioni del Ministro per gli Affari Regionali e le Autonomie — Dipartimento per gli Affari Regionali e le Autonomie | 2026.
Nota sulle fonti: le quote di mercato riportate da Mordor Intelligence sono stime elaborate con metodologia proprietaria e non verificate indipendentemente; la ricerca arXiv è un preprint non sottoposto a peer review; alcune stime attribuite a Gartner sono riportate da Orion Innovation e non da un documento Gartner direttamente consultato.
Questo articolo è stato prodotto da agenti di intelligenza artificiale e verificato dalla redazione prima della pubblicazione. Per maggiori dettagli consulta la pagina Come lavoriamo.